
Criando seu Primeiro Ambiente no Microsoft Fabric!
Nos três posts anteriores entendemos o porquê (fim dos silos), o onde (OneLake e Delta Parquet) e o quem (capacidade, workspaces e permissões).
Chegou a hora de sujar as mãos. Ao final deste post você terá um ambiente funcional, com um arquivo transformado em tabela Delta e consultado via Spark e via SQL.
O que você vai precisar:
Uma conta corporativa ou escolar da Microsoft (contas pessoais como @gmail ou @outlook não funcionam para o trial do Fabric).
Um arquivo CSV qualquer de vendas (pode ser fictício, veja o exemplo no Passo 4).
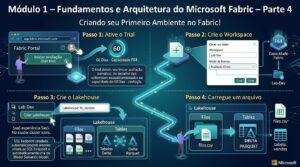
Passo 1: Ative o Trial
- Acesse app.fabric.microsoft.com e faça login
- Clique no ícone do seu perfil (canto superior direito)
- Escolha Iniciar avaliação (Start trial) e confirme
- Você recebe 60 dias de uma capacidade equivalente a uma F64
Obs: Não apareceu a opção? O administrador do tenant pode ter desabilitado o trial. Nesse caso, peça a liberação no Portal de Administração do Fabric ou use uma capacidade F (F2 que é o suficiente para os estudos) contratada no Azure.
Passo 2: Crie o Workspace
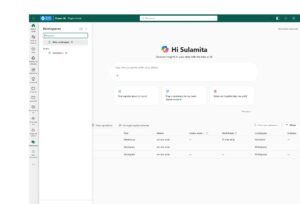
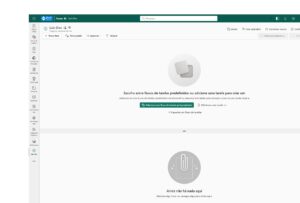
- No menu lateral, clique em Workspaces > Novo workspace
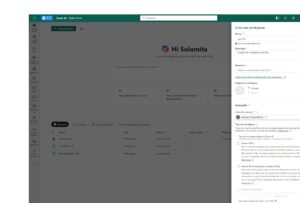
- Dê um nome seguindo o padrão de ambiente que vimos: `Lab-Dev`
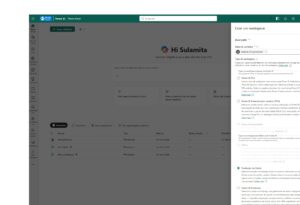
- Abra a seção Avançado e confira o Modo de licença: deve estar em Avaliação (Trial) ou em uma capacidade Fabric
- Clique em AplicarObs: Por quê? Lembra da regra de ouro da Parte 3? Um workspace só usa os recursos do Fabric se estiver atrelado a uma capacidade. Sem esse passo, o botão de criar Lakehouse simplesmente não funciona.
Passo 3: Crie o Lakehouse
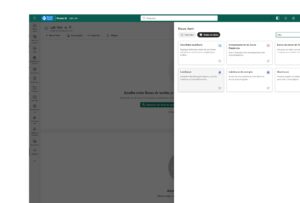
- Dentro do workspace, clique em Novo item e escolha Lakehouse
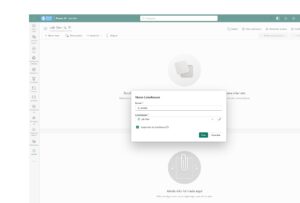
- Nomeie como `lh_vendas` e confirme
- Em segundos, o ambiente está pronto. Sem cluster para configurar, sem rede virtual, sem dimensionar máquina: é o SaaS trabalhando por você
- Ao abrir o Lakehouse, repare nas duas áreas do painel esquerdo:
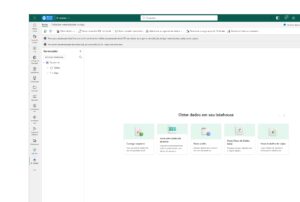
- Files: Arquivos brutos, do jeito que chegaram (CSV, JSON, imagens, Parquet)
- Tables: Tabelas Delta gerenciadas, prontas para Spark, SQL e Power BI
Obs: O Lakehouse também cria automaticamente, sem custo extra, um endpoint de análise SQL e um modelo semântico padrão. É o “OneCopy” na prática.
Passo 4: Carregue um arquivo
Se não tiver um CSV à mão, crie um arquivo chamado `vendas.csv` com este conteúdo:
“`csv
id_venda,data_venda,produto,quantidade,valor_unitario
1,2026-01-05,Notebook,2,4500.00
2,2026-01-05,Mouse,10,80.00
3,2026-01-06,Teclado,5,150.00
4,2026-01-07,Monitor,3,1200.00
5,2026-01-07,Mouse,4,80.00
“`
Depois:
Passe o mouse sobre Files, clique nos três pontinhos (…) e escolha Carregar > Carregar arquivos.
Selecione o `vendas.csv`.
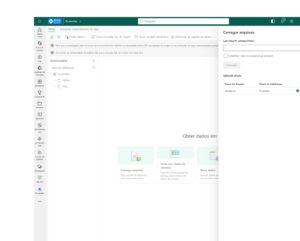
Dica: se você instalou o OneLake File Explorer (Parte 2), basta arrastar o arquivo para a pasta `Files` do Lakehouse no Windows Explorer. Ele sobe sozinho.
Com o ambiente configurado e o nosso arquivo bruto pronto no Lakehouse, no próximo post (Parte 4.1) vamos para a prática final:
-
Transformar o CSV em uma tabela Delta gerenciada;
-
Consultar os dados usando Spark e SQL ao mesmo tempo (zero cópia!);
-
Espiar o Delta Log por baixo dos panos;
-
Dicas de troubleshooting para resolver erros comuns.
Nos vemos na Parte 4.1. Até lá!
#Fabric #Microsoft #MVP #Azure