
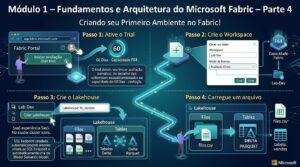
Dando continuidade ao post Módulo 1 – Fundamentos e Arquitetura do Microsoft Fabric – Parte 4, onde ativamos nosso ambiente Lab-Dev e carregamos o arquivo bruto no Lakehouse lh_vendas, vamos agora finalizar nossa prática!
Nesta segunda etapa, vamos transformar esses dados brutos em uma tabela Delta gerenciada, consultar a mesma tabela usando Spark e SQL simultaneamente (sem duplicar nada!) e espiar o Delta Log por baixo dos panos.
Passo 5: Transforme o arquivo em uma tabela Delta
- Em Files, clique nos três pontinhos ao lado de `vendas.csv`
- Escolha Carregar em tabelas > Nova tabela
- Nomeie a tabela como `vendas`, confira o cabeçalho e confirme
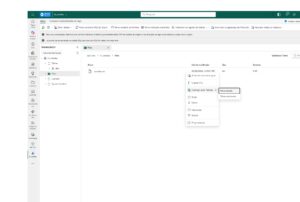
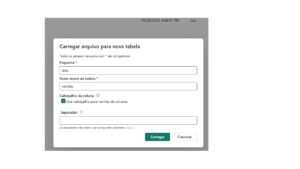
O Fabric lê o CSV e grava os dados em Delta Parquet dentro de `Tables/vendas`.
Agora temos uma tabela com transações ACID, Time Travel e o Delta Log.
Passo 6: Consulte a tabela de duas formas
- Via Spark (Notebook):
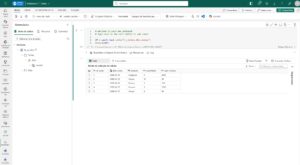
- Na faixa superior do Lakehouse, clique em Abrir notebook > Novo notebook
- Execute em uma célula:
df = spark.read.table(“lh_vendas.dbo.vendas”)
display(df)
- Via SQL:
- No canto superior direito do Lakehouse, troque Lakehouse para Endpoint de análise SQL.
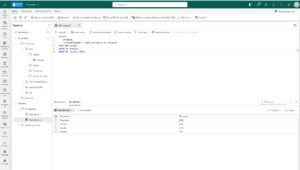
Abra uma nova consulta SQL e execute:
- No canto superior direito do Lakehouse, troque Lakehouse para Endpoint de análise SQL.
sql
SELECT
produto,
SUM(quantidade * valor_unitario) AS receita
FROM dbo.vendas
GROUP BY produto
ORDER BY receita DESC;
O mesmo dado físico, dois motores diferentes, zero cópia.
Passo 7: Espie o Delta Log
- Abra um Notebook no seu workspace (ou crie um novo clicando em Novo notebook no menu superior).
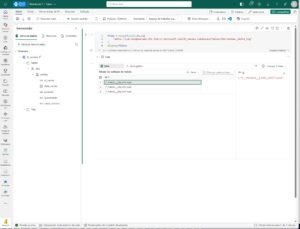
- Adicione uma nova célula de código e cole o comando abaixo para listar os arquivos dentro da pasta do Delta Log da tabela
vendas
# Lista o conteúdo da pasta _delta_log da tabela vendas
files = mssparkutils.fs.ls(
“abfss://Lab-Dev@onelake.dfs.fabric.microsoft.com/lh_vendas.Lakehouse/Tables/dbo/vendas/_delta_log”
)
display(files)
- Em seguida, para ler o conteúdo exato do arquivo
00000000000000000000.json(que registra a criação da tabela, o schema, os metadados e os primeiros arquivos Parquet), adicione outra célula e execute:
# Lê o arquivo JSON do Delta Log e exibe as linhas de transação
df = spark.read.json(
“abfss://Lab-Dev@onelake.dfs.fabric.microsoft.com/lh_vendas.Lakehouse/Tables/dbo/vendas/_delta_log/00000000000000000000.json”
)
display(df)
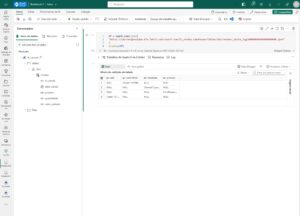
Ao executar esse código, você verá exatamente a estrutura de metadados, o esquema da tabela (schema), o protocolo e as ações iniciais gravadas pelo Delta Lake.
Conclusão: Em poucos cliques, uma plataforma inteira.
Em cerca de minutos você ativou uma capacidade, organizou um workspace, criou um Lakehouse e consultou o mesmo dado com Spark e SQL, sem mover uma linha.
Você agora tem a base para o próximo passo.
No Módulo 2 vamos aprofundar o Lakehouse e organizar nossos dados em camadas com a Arquitetura Medalhão (Bronze, Silver e Gold).
Nos vemos lá!
Parte 1 | Parte 2 | Parte 3 | Parte 4